דלג לתוכן

חדשות AI

תדריך קצר בימי שני ושישי: מה השתנה בעולם ה-AI ולמה זה חשוב לעסק.

נובמבר 2026

2 ימים עם תדריך · 23 כתבות

א׳
ב׳
ג׳
ד׳
ה׳
ו׳
ש׳
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
1710
1813
19
20
21
22
23
24
25
26
27
28
29
30
חיפוש בכל התדריכים

התדריך של 17.11.2026

היום בתדריך: Stripe השלימה את רכישת OpenRouter, ElevenLabs רוכשת את Kotoba היפנית, ו-Alibaba השיקה את Qwen4-Max עם חלון הקשר של מיליון טוקנים. בתחום הקול והווידאו: ZONOS3-Mini בקוד פתוח, מדד מהירות חדש למודלי הקראה, Seedance 2.5 ב-4K לכל המפתחים, ואזהרה על הפסקה אפשרית של Veo 3.1.

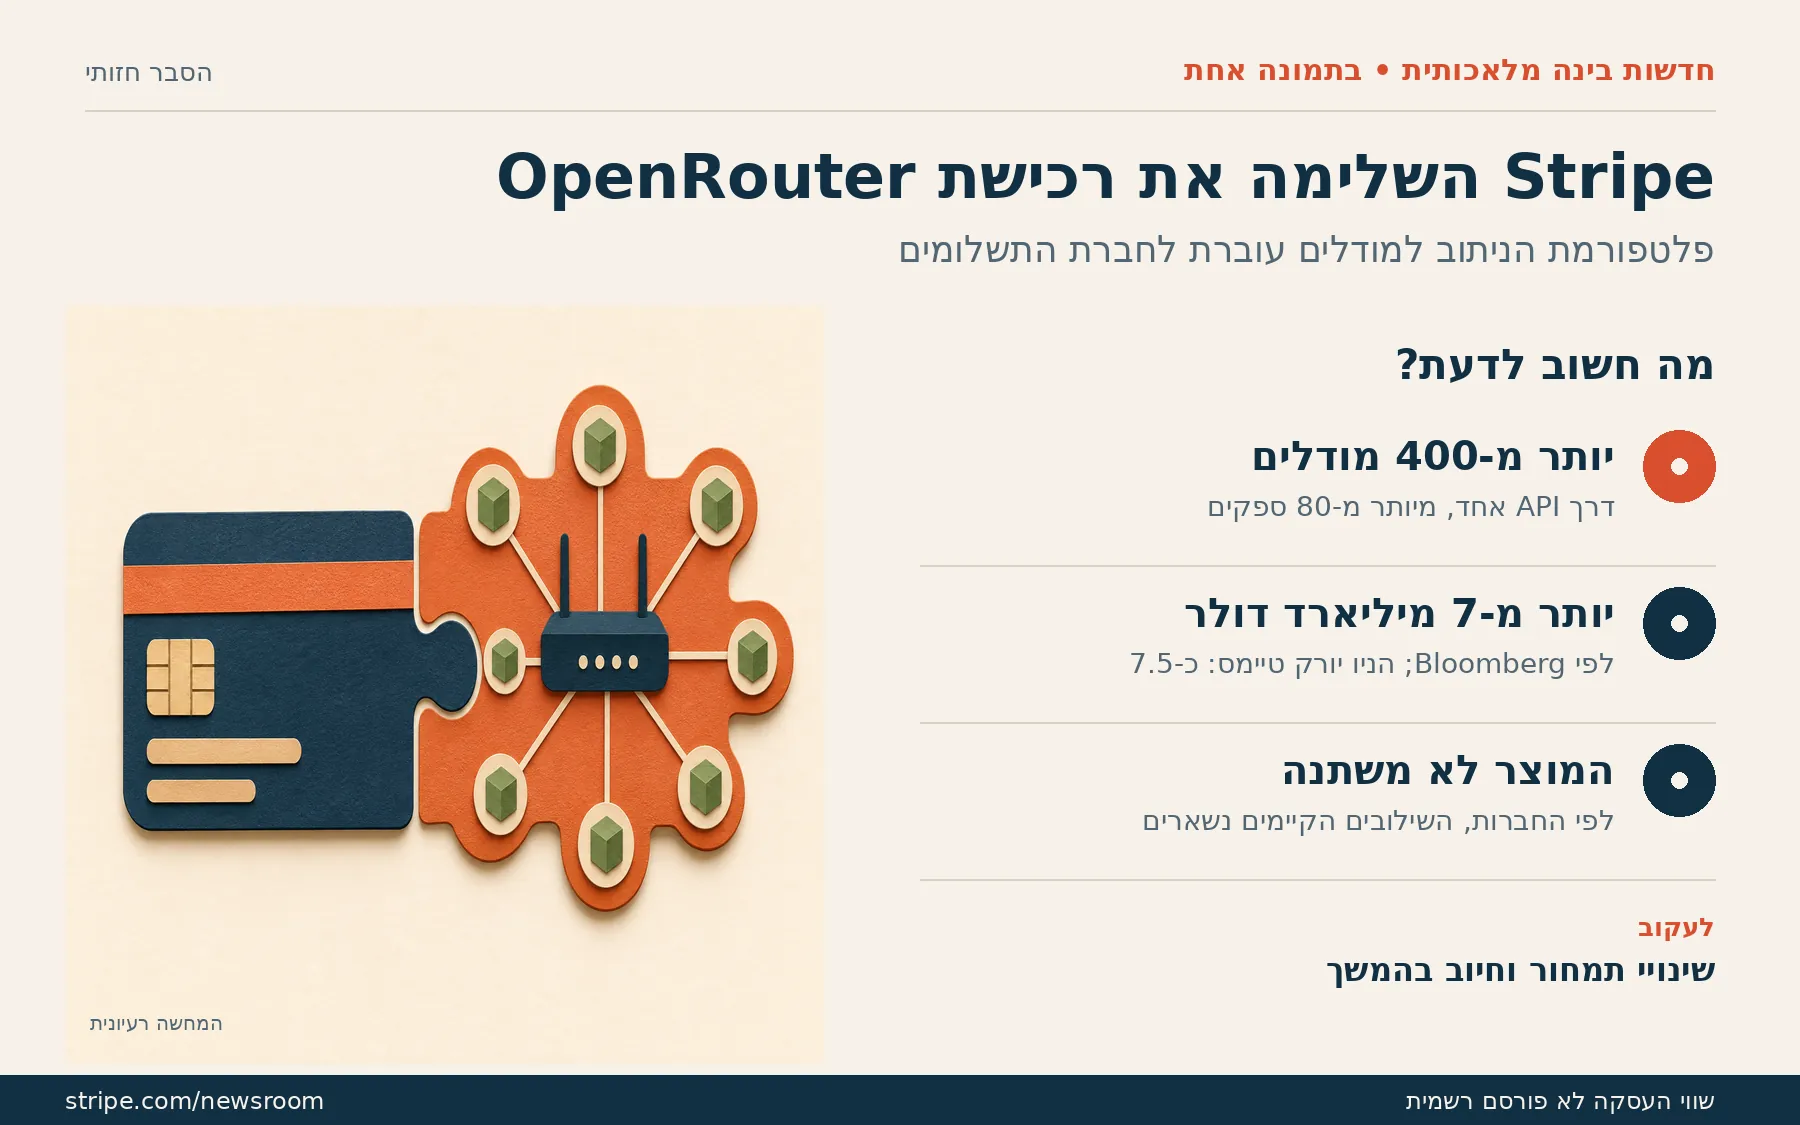
כרטיס הסבר על השלמת רכישת OpenRouter על ידי Stripe: איור של שתי חתיכות פאזל, כרטיס תשלום ורכזת רשת עם קווים למודלים, ולצדו 400 מודלים, שווי של יותר מ-7 מיליארד דולר והמוצר שלא משתנה.

רקע

Stripe השלימה את רכישת OpenRouter

Stripe השלימה את רכישת OpenRouter, פלטפורמה שמאפשרת למפתחים לגשת להרבה מודלי AI דרך חיבור אחד. Stripe היא חברת תשלומים שמספקת לעסקים תשתית לגבייה ולחיוב באינטרנט. OpenRouter מאפשרת לשלוח בקשות ליותר מ-400 מודלים של יותר מ-80 ספקים דרך API אחד, כלומר ממשק אחד שאליו מתחבר הקוד. לפי OpenRouter, הפלטפורמה נותנת גישה למודלים חדשים, ממשיכה לעבוד כשספק מסוים נופל, ומאפשרת להגדיר מדיניות הוצאות ונתונים לכל צוות. הרכישה סוכמה ב-19 באוגוסט 2026, ובאמצע נובמבר שתי החברות הודיעו שהיא הושלמה. כלומר, זו לא עסקה חדשה, אלא סגירה של העסקה שהוכרזה בקיץ. לפי OpenRouter, ההצטרפות ל-Stripe תאפשר לה לבנות מהר יותר ולתמוך בחברות בכל גודל. Stripe לא פרסמה מחיר רשמי. Bloomberg דיווח באוגוסט שמדובר ביותר מ-7 מיליארד דולר, ו-The New York Times דיווח על כ-7.5 מיליארד. לפי Glitchwire, זו העסקה הגדולה ביותר בתולדות Stripe. לפי OpenRouter, יותר מ-10 מיליון מפתחים ועסקים משתמשים בשירות שלה. החברה הדגישה שהיא נשארת ניטרלית, כלומר המודלים והספקים ממשיכים להתחרות על איכות, אמינות ומחיר, והלקוח בוחר. בפוסט מאוגוסט OpenRouter כתבה שהשם, המוצר ותוכנית הפיתוח נשארים, ושאין שינוי בשילובים קיימים. שתי החברות אמרו שהן יעבדו יחד כדי לעזור לעסקים לבחון מודלים עסקיים חדשים ולשפר את השימוש בטוקנים. לפי TokenPost, בשלב זה מדובר בתוכנית, ועוד לא פורסמו מוצרים משותפים. החיבור ביניהן לא מתחיל מאפס. כבר בינואר Stripe אפשרה למפתחים שמשתמשים ב-OpenRouter לעקוב אחרי השימוש במודלים, להחיל תמחור ולחייב לקוחות באופן אוטומטי. מה זה אומר לבעל עסק קטן או למי שבונה מוצר AI? מי שמשתמש ב-OpenRouter לא אמור להרגיש שינוי מיידי. בטווח הארוך, השילוב יכול לקשר בין העלות של קריאות למודלים לבין החיוב של הלקוחות במקום אחד. כדאי לעקוב אחרי שינויים בתנאים או בתמחור בחודשים הקרובים.

למה זה חשוב: אם VoiceX מנתבת מודלים דרך OpenRouter, לפי שתי החברות אין שינוי מיידי, אבל כדאי לעקוב אחרי שינויי תמחור וחיוב.
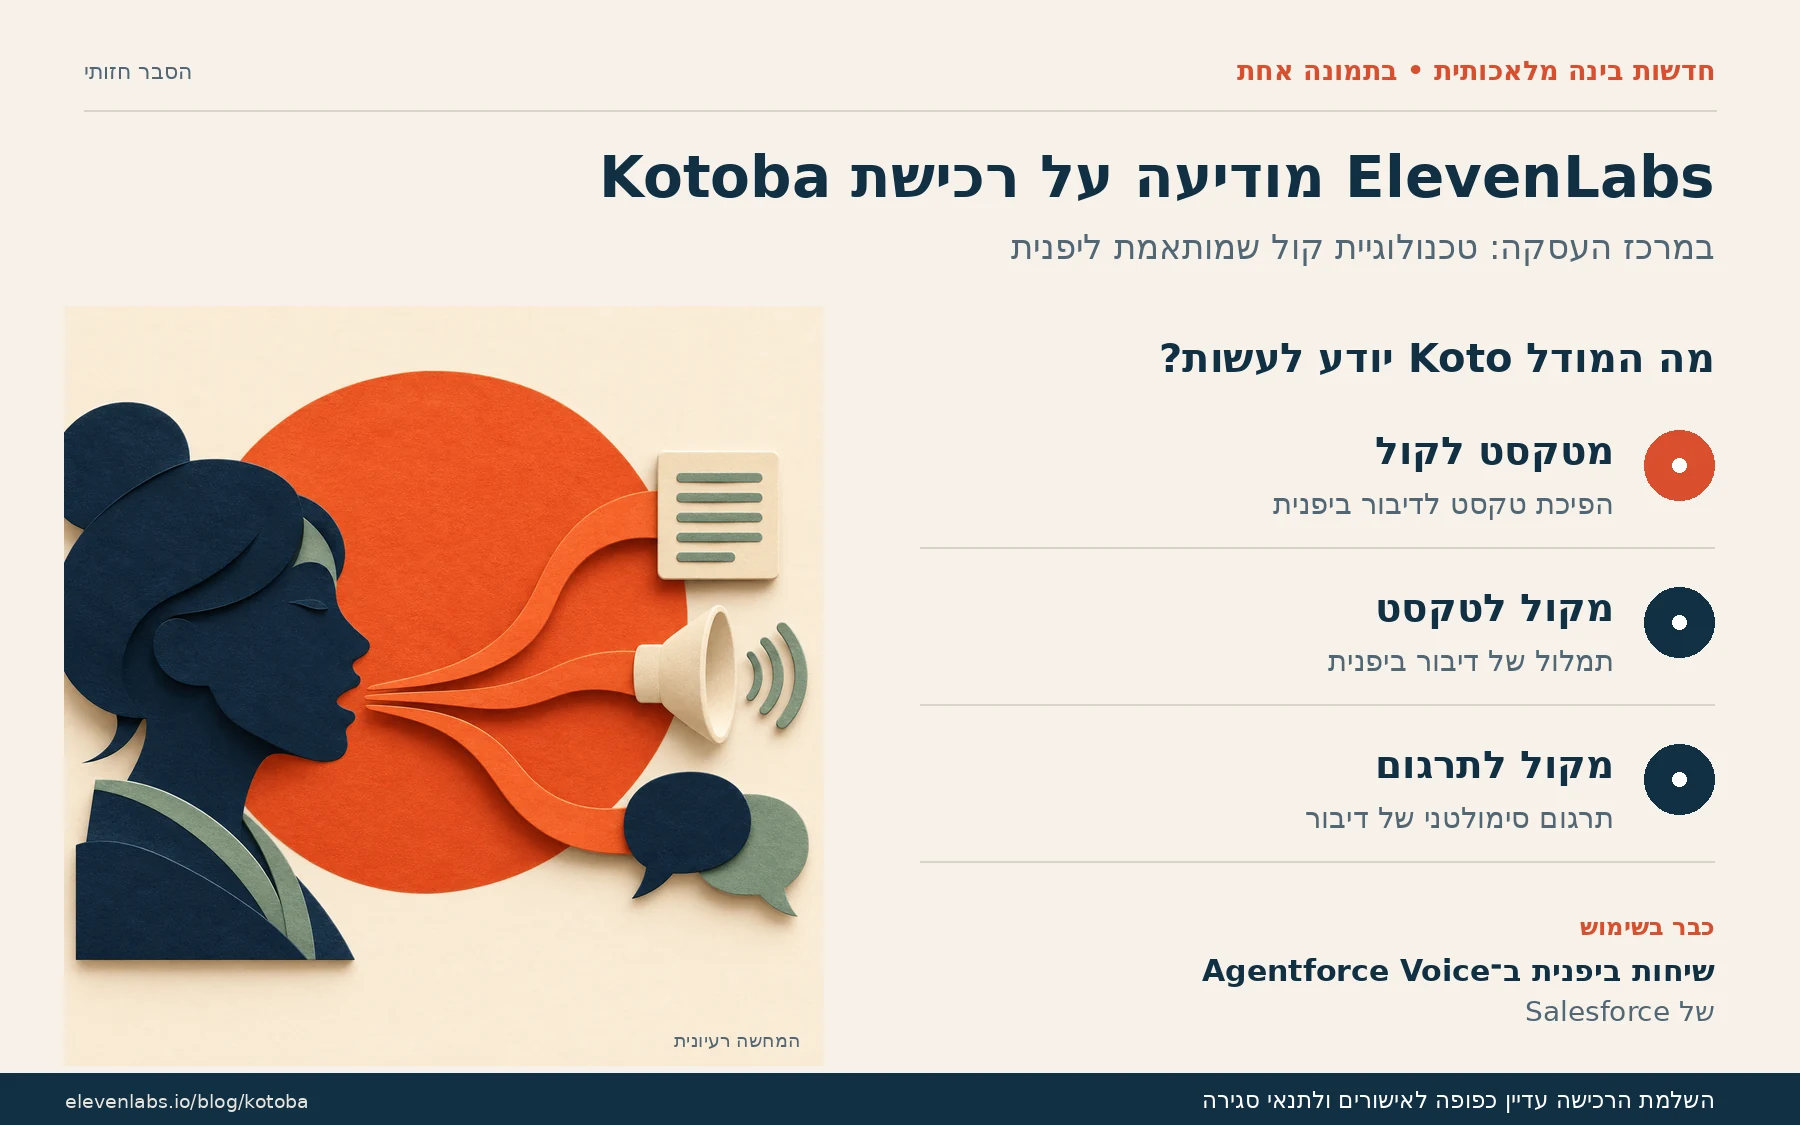
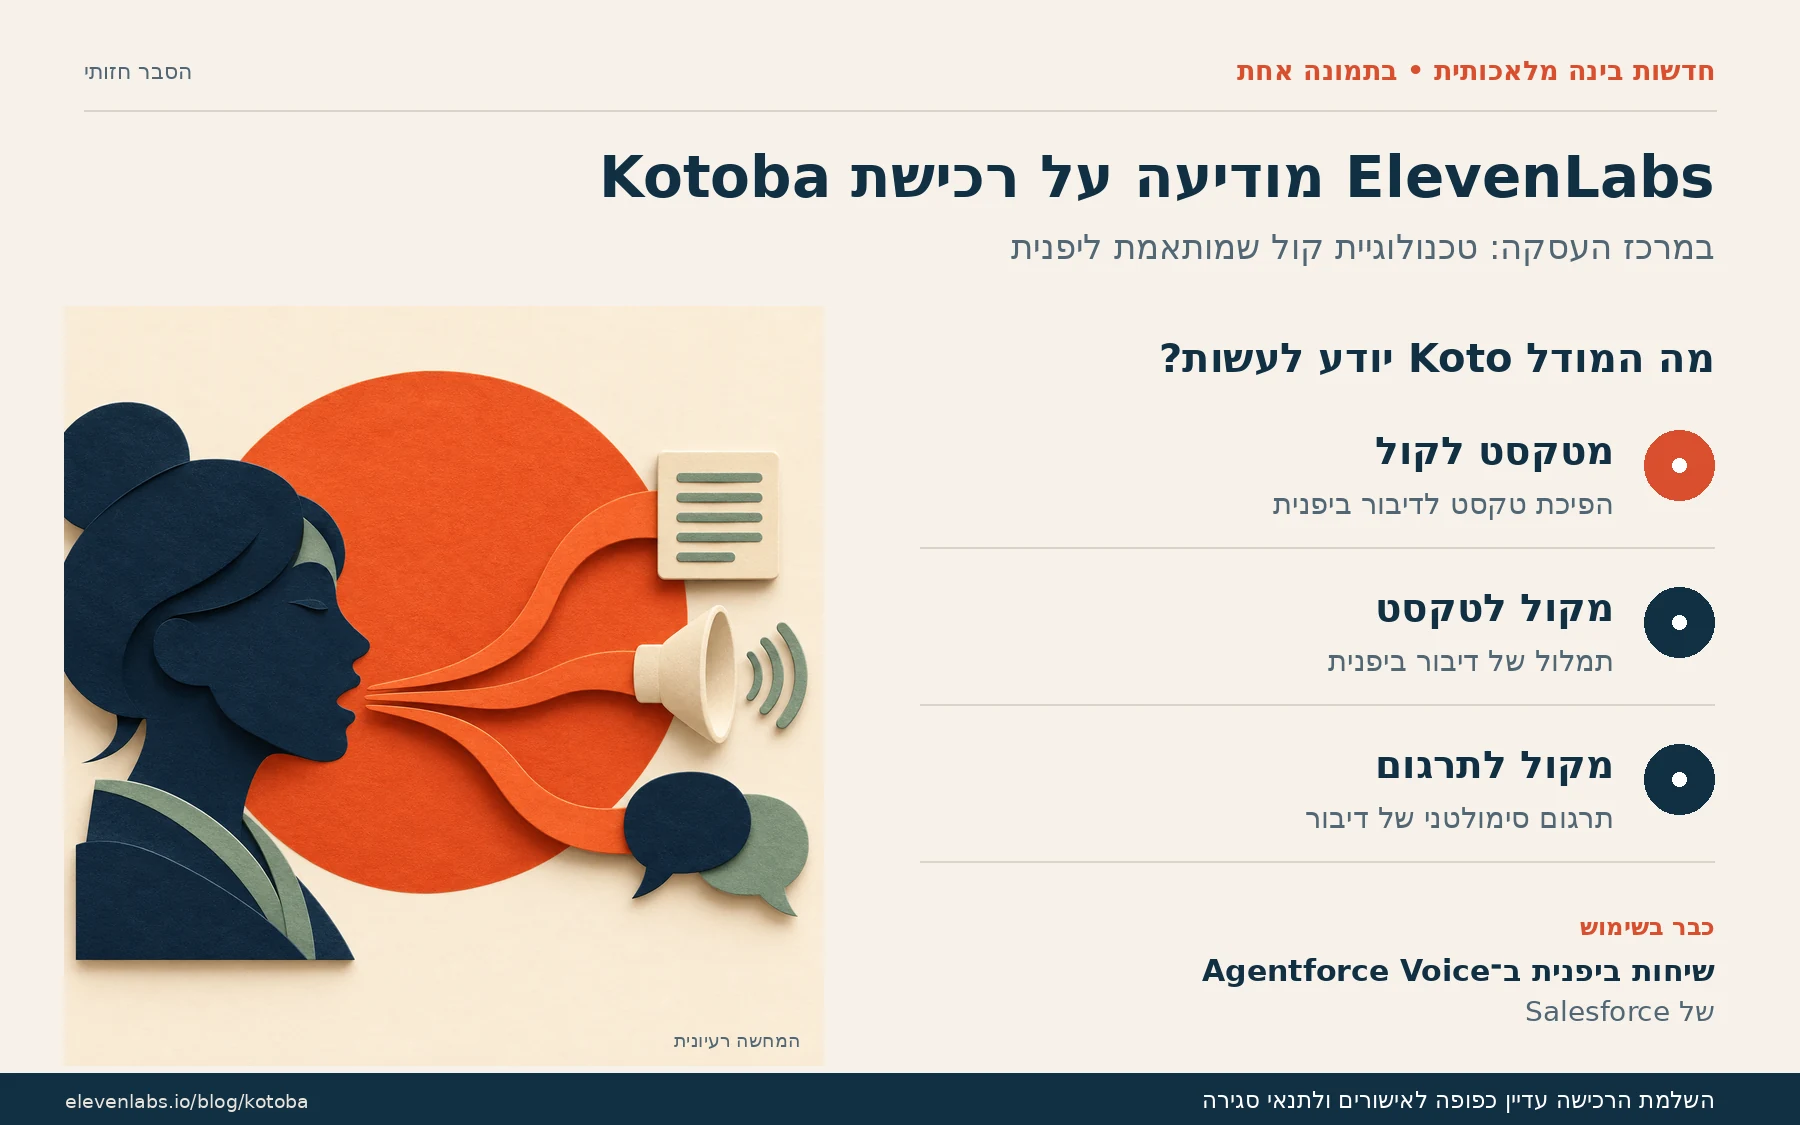
כרטיס הסבר על רכישת Kotoba על ידי ElevenLabs: איור נייר של פרופיל אישה שמדברת, עם גלי קול שעוברים לטקסט, רמקול ובועות דיבור, ולצדו היכולות של מודל Koto: טקסט לקול, קול לטקסט ותרגום.

רקע

ElevenLabs רוכשת את Kotoba היפנית

ElevenLabs הודיעה ב-16 בנובמבר שהיא רוכשת את Kotoba Technologies, מעבדת בינה מלאכותית קולית מיפן. לפי ההודעה בבלוג של ElevenLabs, העסקה צפויה להיסגר בהמשך הרבעון הרביעי של 2026, בכפוף לאישורים רגולטוריים ולתנאי סגירה מקובלים. המחיר ותנאים כספיים אחרים לא פורסמו.

Kotoba נוסדה ב-2023 על ידי שני חוקרים. נוריוקי קוג׳ימה, המנכ״ל, בעל דוקטורט ממדעי המחשב מאוניברסיטת קורנל, עבד כחוקר ב-Hugging Face והשתתף בבניית Fugaku-LLM, מודל יפני בקוד פתוח שאומן על מחשב העל Fugaku. ג׳ונגו קסאי, מנהל הטכנולוגיה, בעל דוקטורט מאוניברסיטת וושינגטון, היה פרופסור במכון טויוטה לטכנולוגיה בשיקגו ומתואר כאחד החוקרים המצוטטים ביותר ביפן.

המודל של החברה נקרא Koto, והוא מתמחה בשלוש יכולות ביפנית: הפיכת טקסט לדיבור, תמלול דיבור לטקסט, ותרגום סימולטני מדיבור לדיבור. לפי ElevenLabs, כמה ארגונים גלובליים גדולים כבר משתמשים בו. החברה היחידה שנזכרת בשמה היא Salesforce: Koto מפעיל את השיחות ביפנית ב-Agentforce Voice, מערכת הסוכנים הקוליים שלה. Salesforce Ventures השקיעה גם ב-ElevenLabs וגם ב-Kotoba.

לדברי ElevenLabs, המטרה היא להאיץ את האימוץ של סוכני בינה מלאכותית וממשקים קוליים ביפן. בחודשים הקרובים היא מתכננת לגייס מנהלי מכירות מקומיים, להמשיך להשקיע בתשתית ביפן ולעבוד עם ארגונים יפניים ועם חברות בינלאומיות שפועלות שם. פיוטר דומבקובסקי, מנהל הטכנולוגיה של ElevenLabs, אמר שיפנית היא שפה מורכבת שמציבה אתגרים טכניים רבים בבניית מודלי קול, ושהשילוב של המחקר ישפר את היפנית בכל המוצרים של החברה. קסאי הוסיף שהשאיפה היא להוביל את הגל הבא של קול בבינה מלאכותית ביפן ובמזרח אסיה.

הרכישה מראה כיוון ברור: ElevenLabs לא מסתפקת במודל כללי אחד, אלא קונה מומחיות עמוקה בשפה ספציפית. מבחינת VoiceX, אין לכך השפעה ישירה על עברית, ולא הוזכרה עברית בהודעה. עם זאת, אם הגישה הזאת תצליח ביפנית, ייתכן שספקים יחפשו בעתיד שיפורים דומים גם לשפות קטנות יותר. כרגע זו הערכה בלבד.

למה זה חשוב: מצביע על התרחבות ElevenLabs לשפות נוספות. אין השפעה ישירה על עברית.

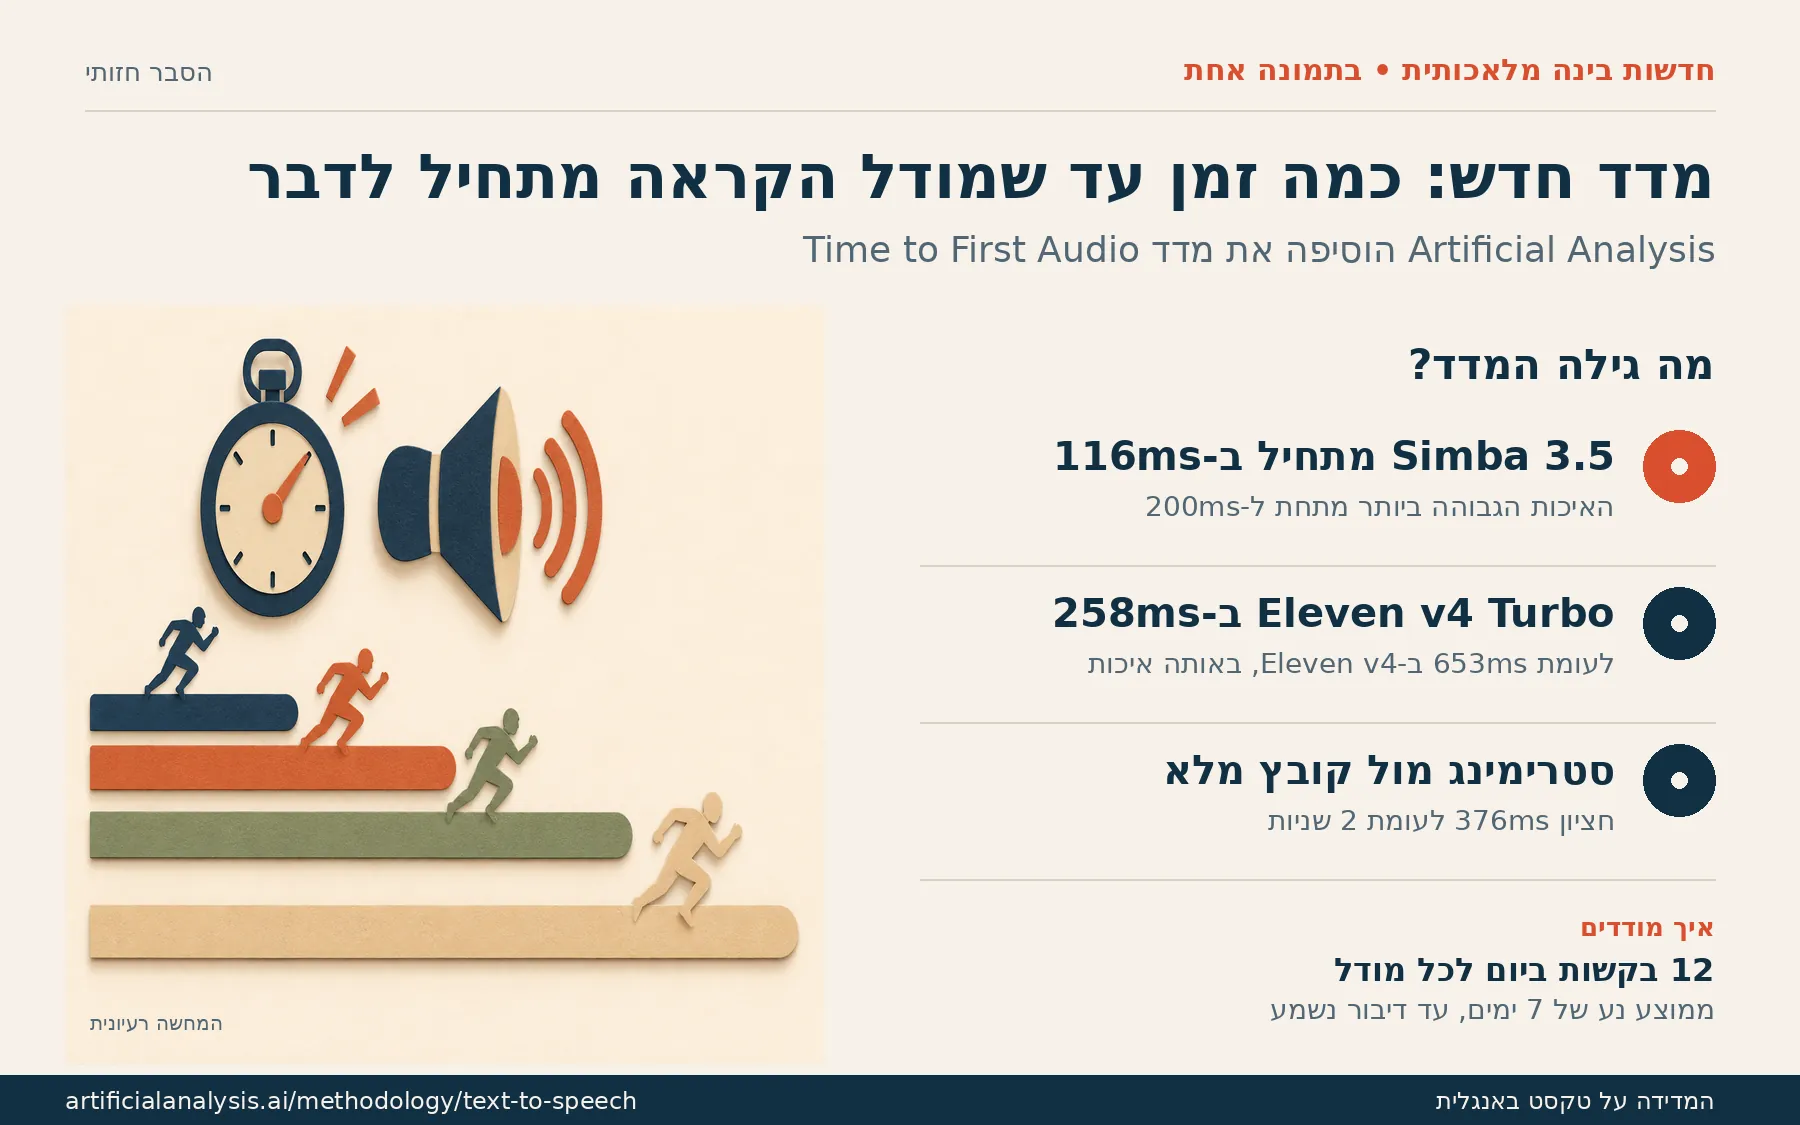
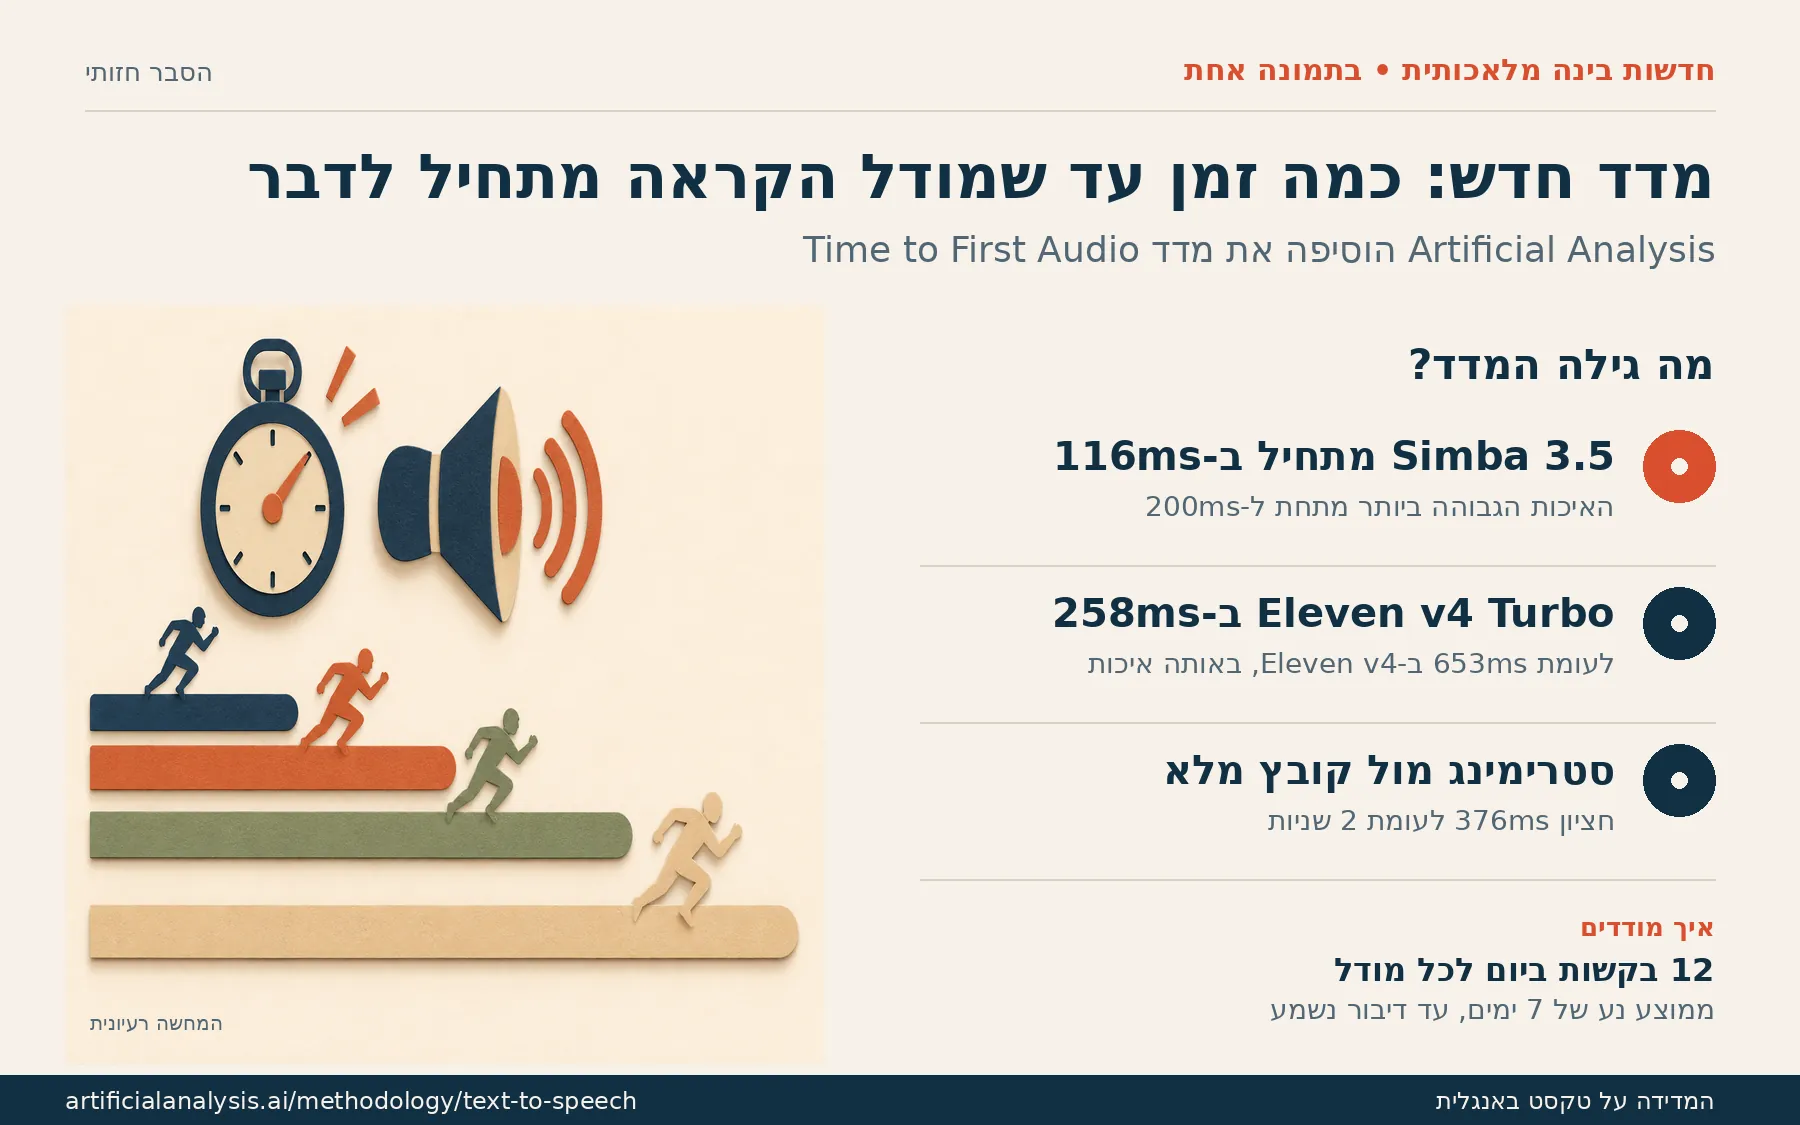
כרטיס הסבר על מדד Time to First Audio של Artificial Analysis: איור של שעון עצר, רמקול ורצים במסלולים באורכים שונים, ולצדו הזמנים של Simba 3.5 ו-Eleven v4 Turbo וחציון הסטרימינג.

עדכונים

Artificial Analysis השיקה מדד זמן עד האודיו הראשון (TTFA) למודלי הקראה

Artificial Analysis, אחד מאתרי ההשוואה הנפוצים בקרב מפתחים, הוסיפה ב-16 בנובמבר מדד חדש לדירוג מודלי הקראה: Time to First Audio, או בקיצור TTFA. המדד בודק כמה זמן עובר מהרגע ששולחים את הטקסט המלא ועד שהמאזין שומע דיבור בפועל. עד עכשיו האתר מדד איכות, הגייה ומהירות יצירה, אבל לא את זמן ההמתנה עד הצליל הראשון. לדברי החברה, זה המספר שקובע אם סוכן קולי מרגיש מגיב או איטי.

לפי דף המתודולוגיה, המדידה לא נעצרת כשמגיע הבייט הראשון. היא מחכה לחלק האודיו הראשון ומוסיפה אליו גם שקט שיש בתחילת ההקלטה. לדוגמה, אם חלק האודיו הראשון מגיע אחרי 100 אלפיות שנייה ואחריו יש 250 אלפיות שנייה של שקט, הזמן שנרשם הוא 350 אלפיות שנייה. כל מודל נבדק מדי יום בשעה אקראית, ב-12 בקשות: שלוש בכל אחד מארבעה אורכי טקסט, מקצר מאוד ועד ארוך. התוצאה המוצגת היא ממוצע של שבעת הימים האחרונים.

לפי הפרסום של Artificial Analysis, הזמנים אצל המודלים המובילים נעים בין 76 אלפיות שנייה לכמעט שנייה. Simba 3.5 של Speechify מתחיל לדבר אחרי 116 אלפיות שנייה, והוא בעל דירוג האיכות הגבוה ביותר מבין המודלים שמתחילים בפחות מ-200 אלפיות שנייה. אחריו Realtime TTS-2 של Inworld עם 186. אצל ElevenLabs, הגרסה Eleven v4 Turbo מתחילה אחרי 258 אלפיות שנייה, לעומת 653 ב-Eleven v4 הרגיל, באותו דירוג איכות. Fish Audio Drama 3 מגיע גם הוא ל-258, ו-Sonic 3.6 של Cartesia ל-287.

הקו המפריד העיקרי הוא סטרימינג. ל-65 מודלים שמחזירים אודיו בהזרמה יש חציון של 376 אלפיות שנייה. 20 מודלים שמחזירים קובץ רק אחרי שסיימו ליצור אותו מגיעים לחציון של 2 שניות. האתר מדד גם יציבות: אצל Gradium TTS מחצית הבקשות האמצעיות נמצאות בטווח של 13 אלפיות שנייה, ואילו Gemini 3.1 Flash TTS נע בין 908 ל-975.

ל-VoiceX, שמפיקה בעיקר קבצי קריינות מוכנים, הנתון הזה פחות קריטי. הוא נעשה חשוב אם מוסיפים חלקים אינטראקטיביים, כמו תצוגה מקדימה מיידית או עוזר קולי. כדאי לזכור שהמדידה מתבססת על פרומפטים באנגלית, ולא נמצא נתון לעברית.

למה זה חשוב: נותן דרך להשוות ספקי TTS גם לפי מהירות ולא רק לפי איכות. רלוונטי בעיקר לחלקים אינטראקטיביים ב-VoiceX.

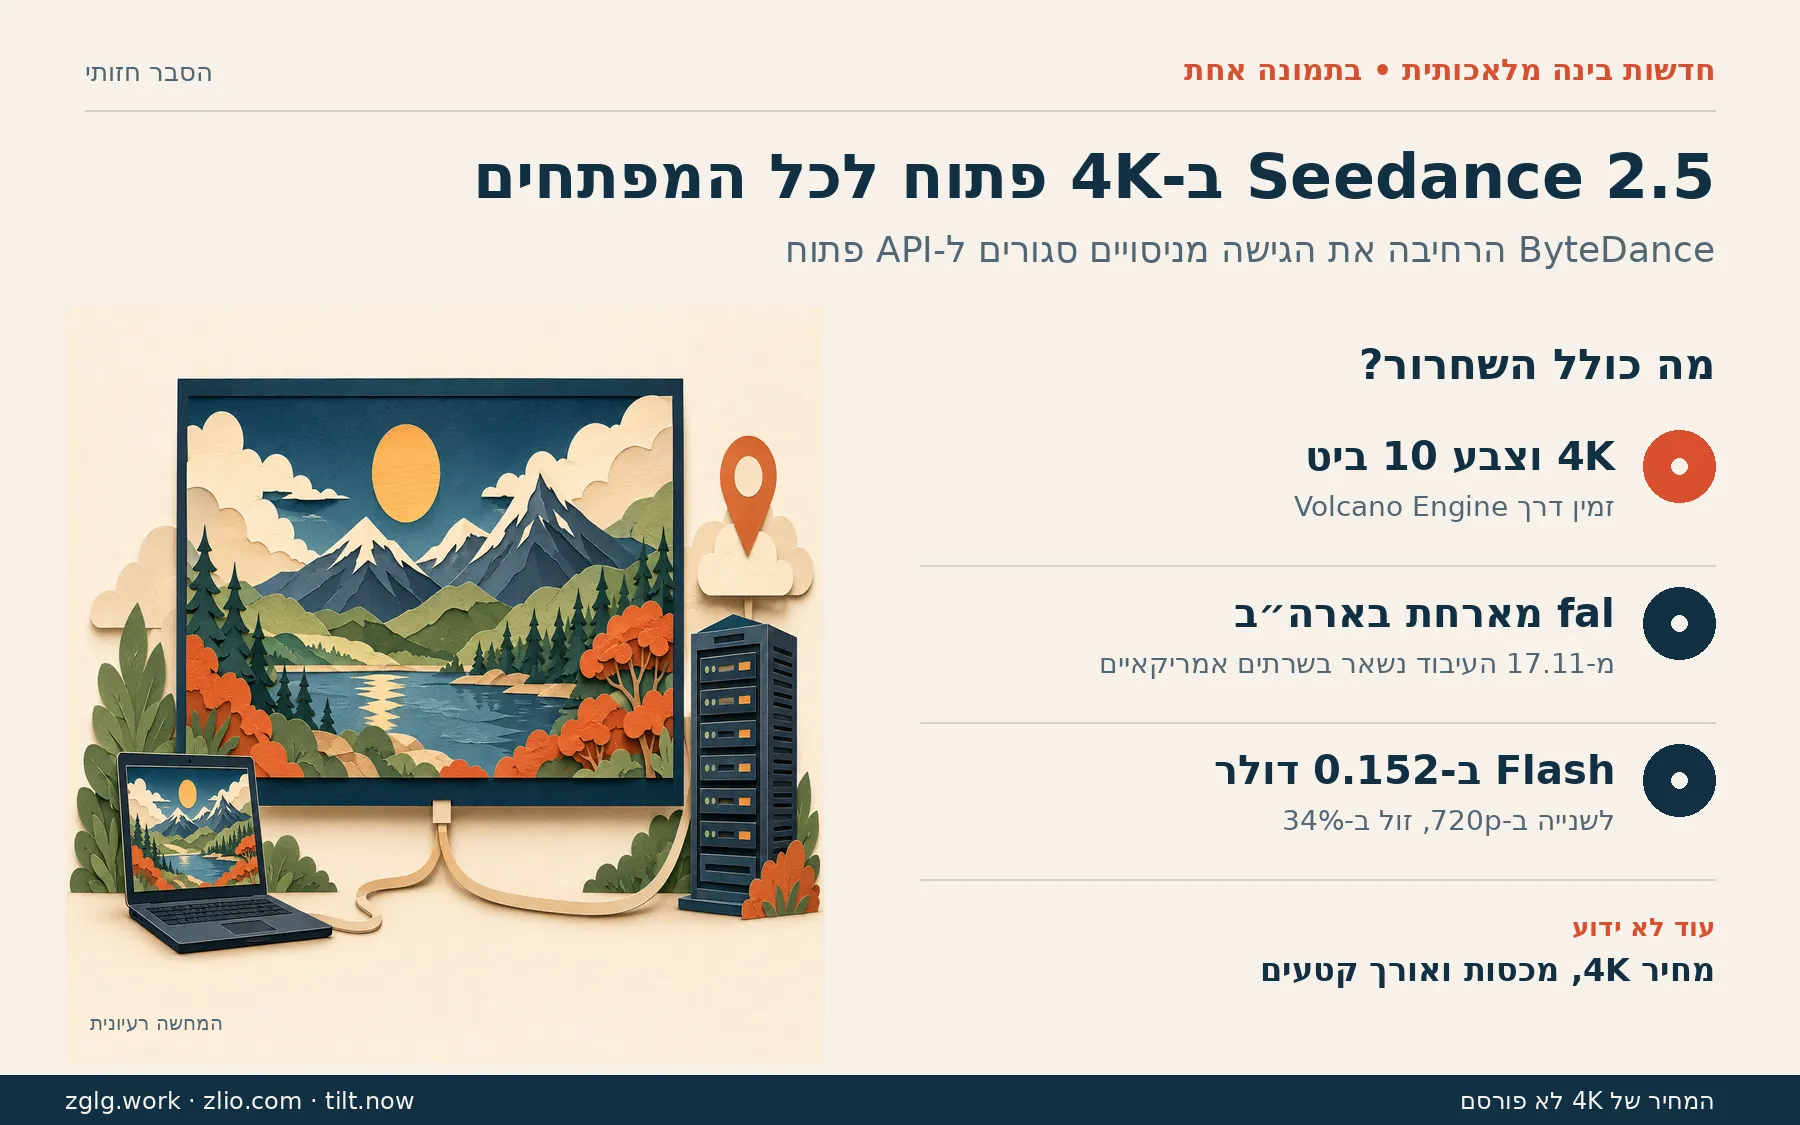
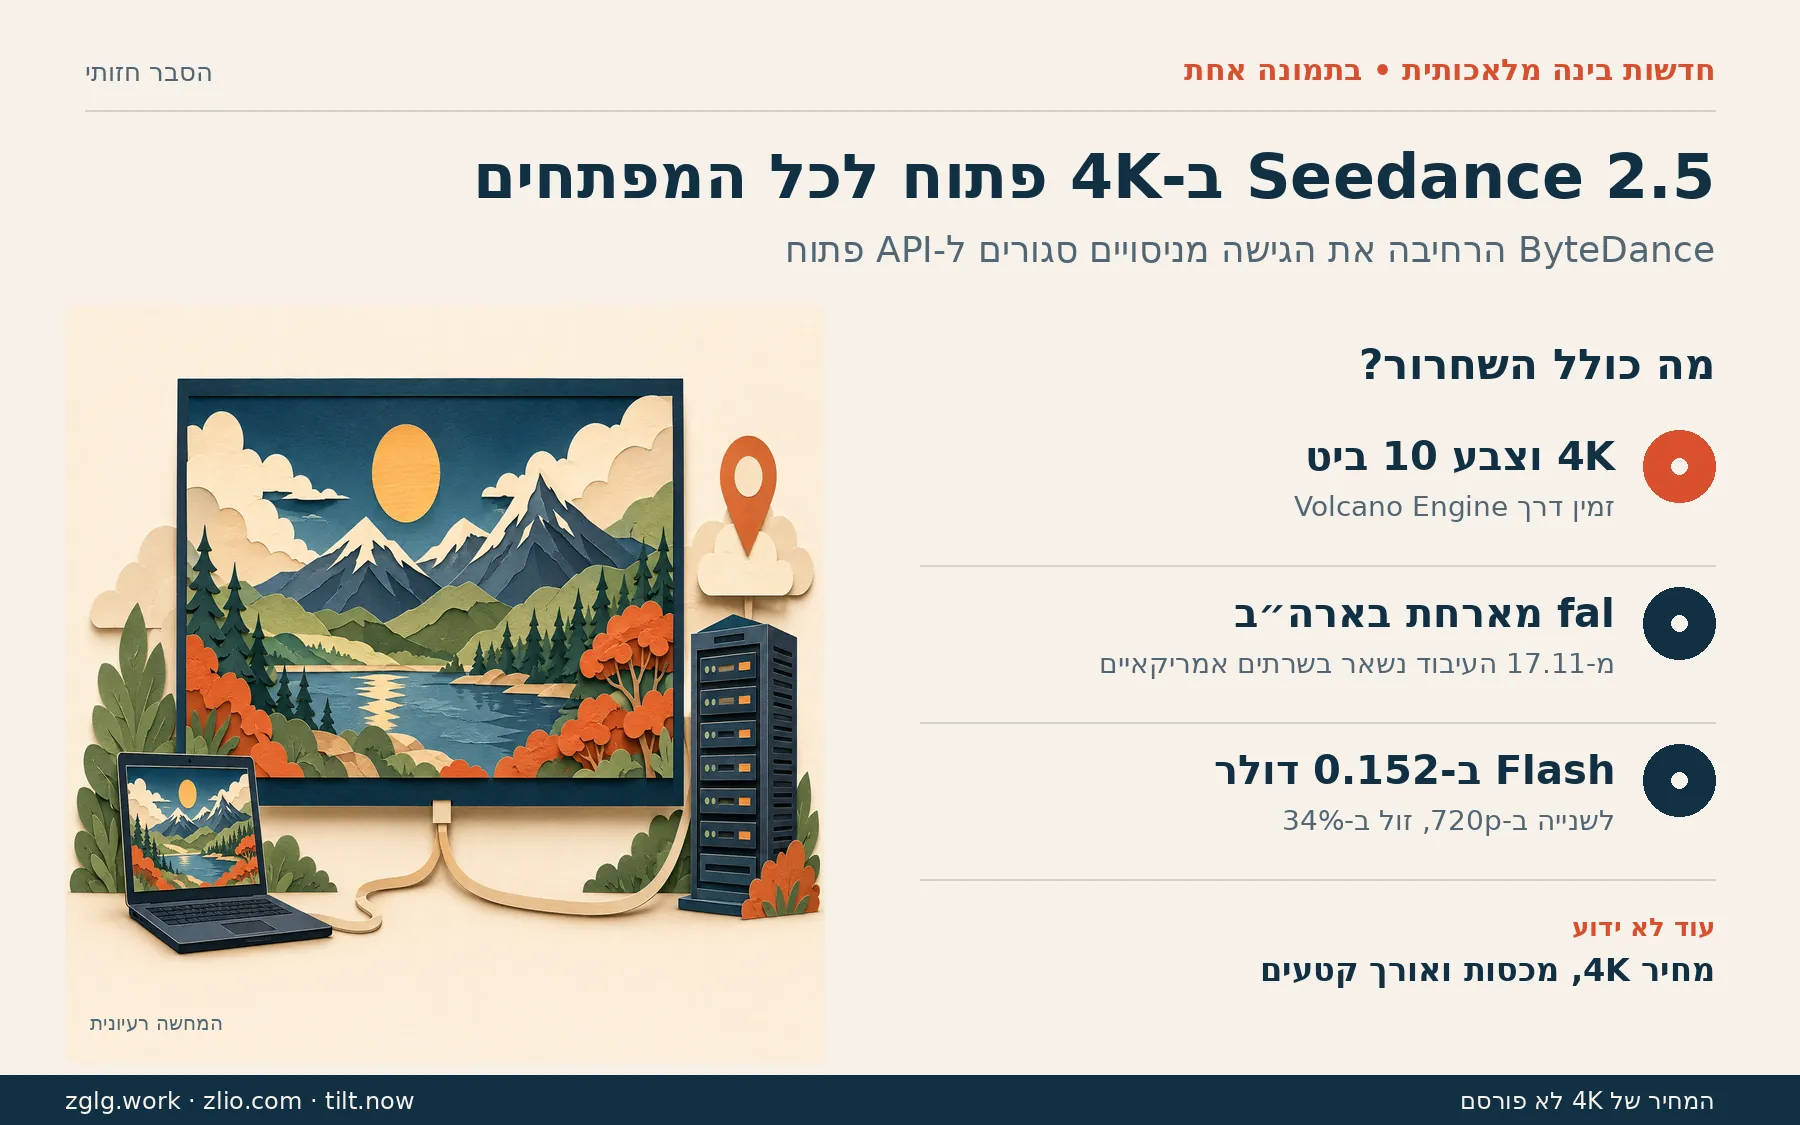
כרטיס הסבר על פתיחת Seedance 2.5 ב-4K לכל המפתחים: איור של מסך גדול עם נוף, מחשב נייד ושרת עם סמן מיקום, ולצדו 4K וצבע 10 ביט, אירוח בארה״ב ב-fal ומחיר Flash.

עדכונים

ByteDance פתחה את Seedance 2.5 4K ב-API לכל המפתחים

ByteDance פתחה ב-16 בנובמבר את ה-API של Seedance 2.5 ברזולוציית 4K לכל המפתחים. לפי דיווח של Phoenix Technology שצוטט באתר ZGLG, עד עכשיו הגישה לגרסה הזאת הייתה מוגבלת לניסויים בהזמנה ולמספר קטן של שותפים. מעכשיו כל מפתח יכול לשלב יצירת וידאו ב-4K בכלים, בתהליכי העבודה ובצינורות התוכן שלו.

לפי Zlio, השירות זמין באופן כללי דרך Volcano Engine, פלטפורמת הענן של ByteDance, ומיועד למפתחים ולארגונים. בנוסף לרזולוציית 4K, הוא כולל עומק צבע של 10 ביט, שמאפשר מעברי צבע חלקים יותר ושימוש טוב יותר בעריכה מקצועית, וגם מצב דגימה. המקורות לא מסבירים בדיוק מה עושה מצב הדגימה.

במקביל, הגרסה מגיעה גם לפלטפורמות צד שלישי. לפי Tilt, ב-16 בנובמבר fal שחררה את מודל ה-4K באופן כללי, וב-17 בנובמבר הוסיפה גרסה שרצה כולה על שרתים בארצות הברית. הסיבה המוצהרת היא לאפשר וידאו באיכות גבוהה בלי שהעיבוד יוצא מגבולות ארה״ב, נושא שחשוב לחברות עם דרישות פרטיות ורגולציה. יום קודם לכן, ב-15 בנובמבר, ByteDance השיקה ב-fal וב-ModelArk את Seedance 2.5 Flash, גרסה מהירה וזולה יותר. לפי הדיווח היא עולה 0.152 דולר לשנייה ב-720p, הוזלה של 34% לעומת דגם הדגל, והיא מהירה כמעט פי שניים.

יש כמה פרטים חשובים שהמקורות לא מציינים: המחיר של גרסת ה-4K, מגבלות שימוש ומכסות, אורכי הקטעים הנתמכים ומידות הפיקסלים המדויקות. ZGLG מציינת שדרישות המחשוב, הזיכרון והתורים של 4K ישפיעו על המחיר ליחידה ועל זמן ההמתנה, ושהשאלה האמיתית היא איכות ויציבות בכמויות של ייצור.

הצעד מעביר וידאו 4K מבינה מלאכותית משלב ההדגמות לשימוש רחב. עבור VoiceX, הרלוונטיות היא בעיקר לתוצרי פרימיום, כי סביר ש-4K יהיה יקר משמעותית מ-720p, אבל בלי מחיר מפורסם אי אפשר לחשב עדיין. כדאי לבדוק את המחיר ב-fal ולהשוות מול Flash לפני שמחליטים.

למה זה חשוב: אפשרות לפלט באיכות גבוהה במיוחד. ל-VoiceX רלוונטי בעיקר לתוצרי פרימיום, כי 4K יקר משמעותית מ-720p.

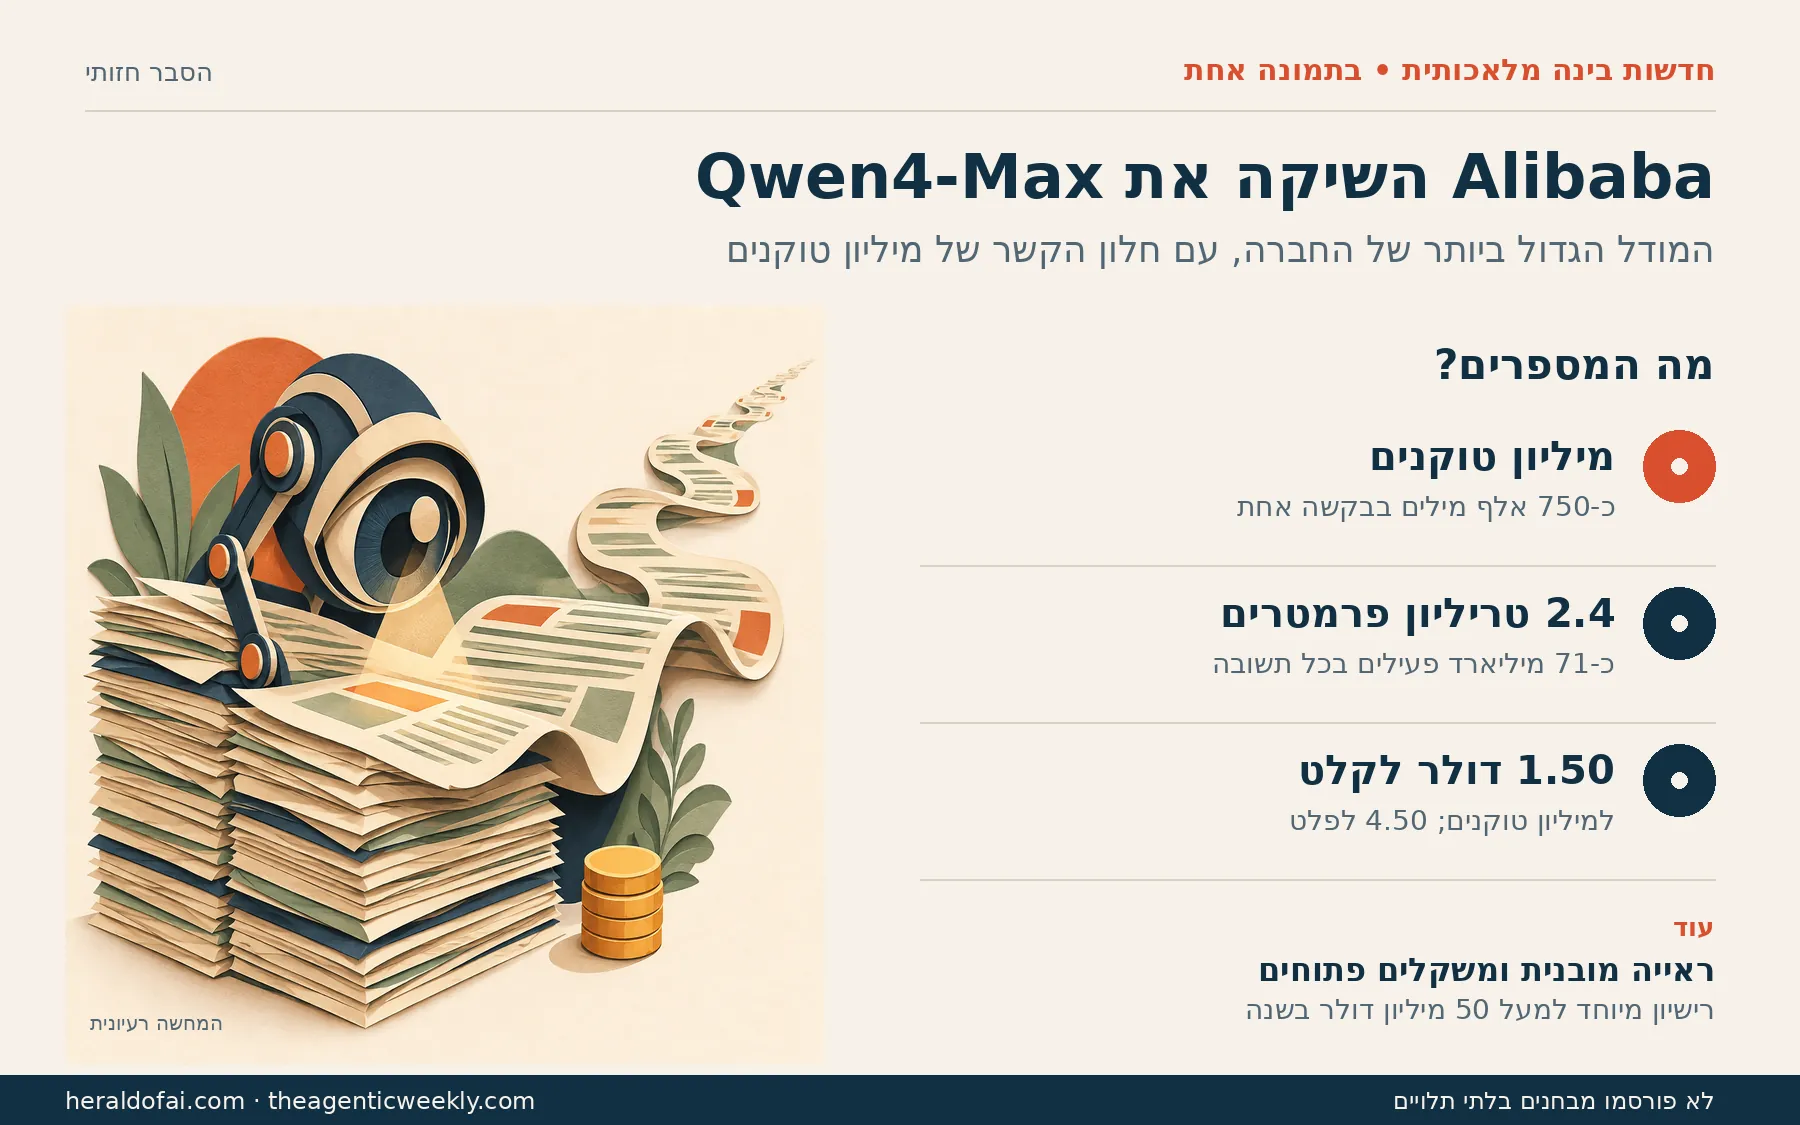
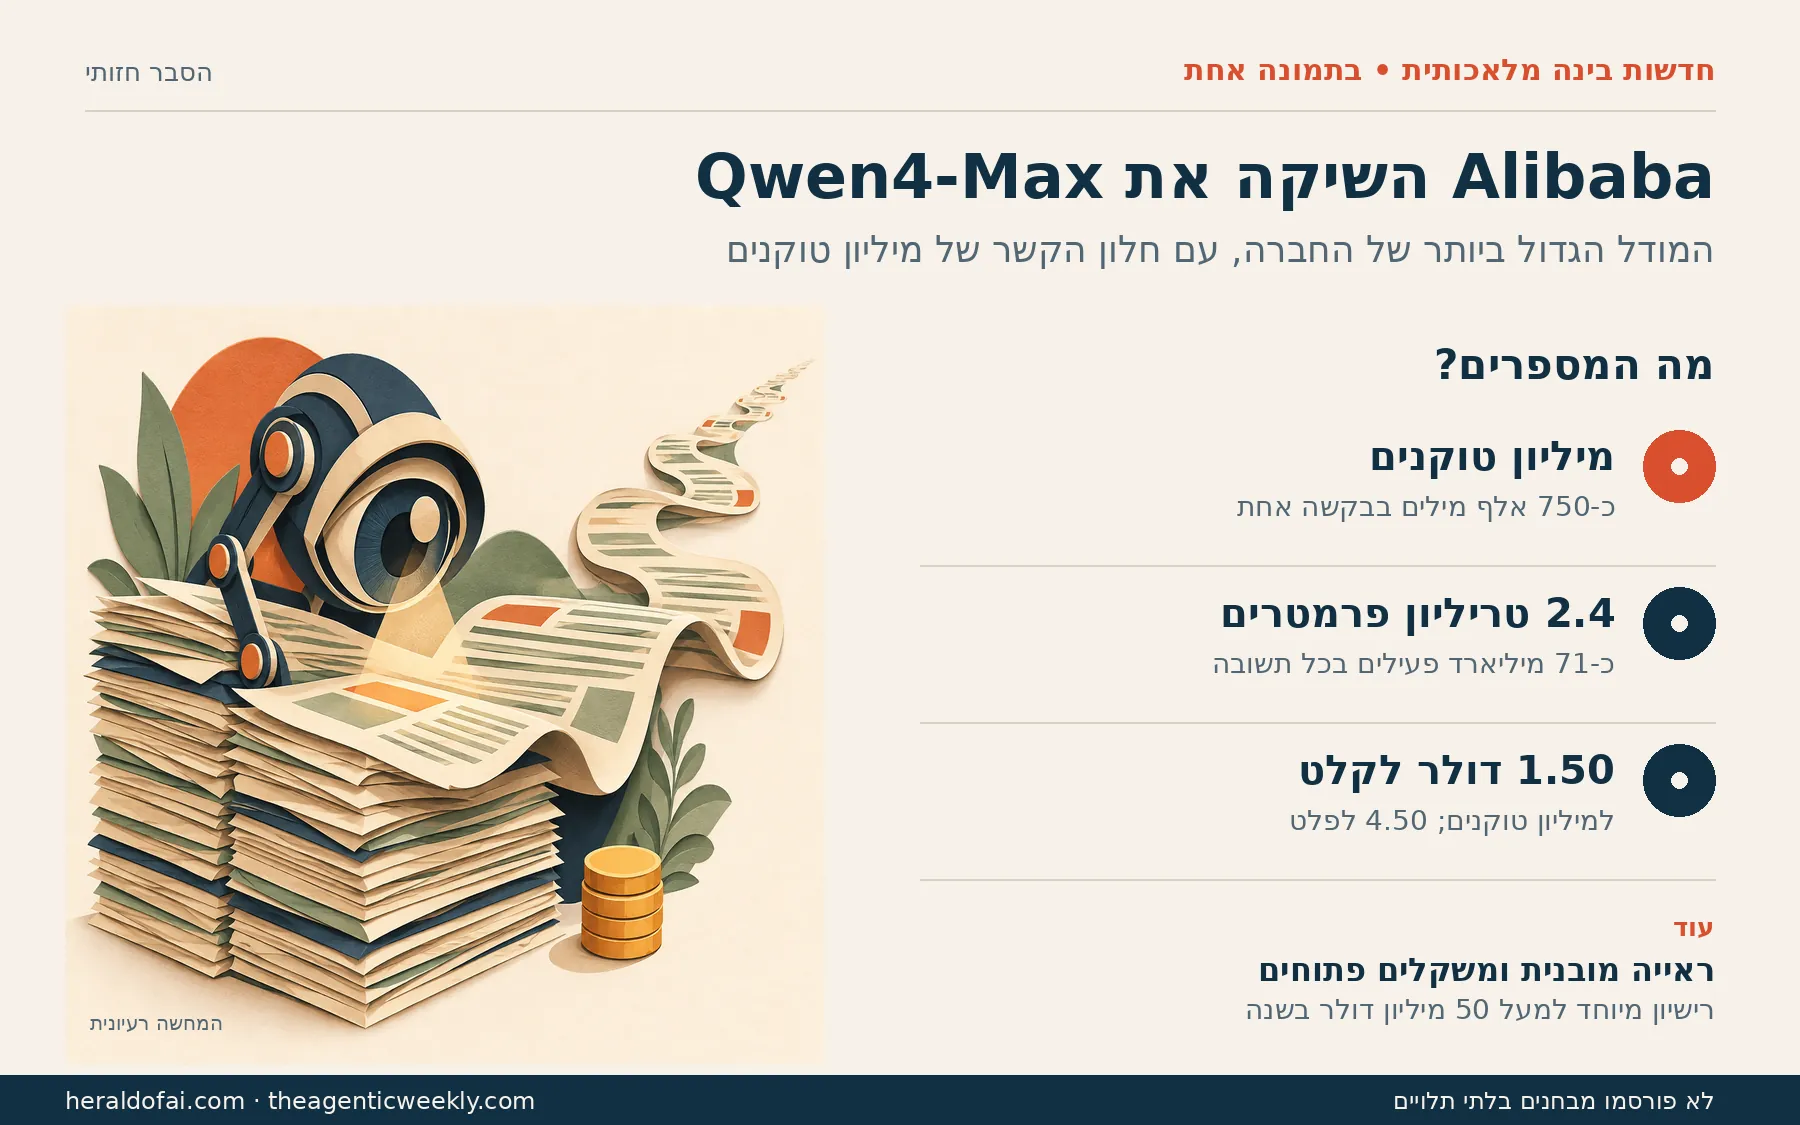
כרטיס הסבר על Qwen4-Max של Alibaba: איור של עדשה מכנית שקוראת ערימת מסמכים ומגילה ארוכה, וערימת מטבעות, ולצדו מיליון טוקנים, 2.4 טריליון פרמטרים ומחיר של 1.50 דולר לקלט.

רקע

Alibaba השיקה את Qwen4-Max

Alibaba Cloud חשפה ב-16 בנובמבר את Qwen4-Max, המודל הגדול ביותר שלה עד היום. לפי Herald of AI, למודל יש 2.4 טריליון פרמטרים בסך הכול, אבל בכל תשובה פעילים רק כ-71 מיליארד מהם. זו ארכיטקטורה מסוג Mixture of Experts, שבה רק חלק מהמודל עובד בכל פעם, וכך החישוב זול יותר ממה שהגודל הכולל מרמז.

הנתון שמשך הכי הרבה תשומת לב הוא חלון ההקשר: מיליון טוקנים, כלומר כ-750 אלף מילים באנגלית בבקשה אחת. בפועל אפשר להזין למודל מסמכים ארוכים מאוד, ספרים שלמים או מאגרי קוד גדולים, ולשאול עליהם שאלות בלי לחתוך אותם לחלקים. למודל יש גם ראייה מובנית: הוא מעבד תמונות ישירות, בלי כלי נפרד, למשל צילומי מסך ותרשימים הנדסיים.

לפי Herald of AI, המחיר דרך שירות הענן של Alibaba הוא 1.50 דולר למיליון טוקנים של קלט. The Agentic Weekly מציין גם 4.50 דולר למיליון טוקנים של פלט. לפי החישוב באתר, הזנה של חצי מיליון מילים תעלה כ-0.75 דולר. Alibaba טוענת שחברות שמשתמשות במודל במוצרים שלהן ראו ירידה של 62% בעלות לכל משימה לעומת גרסאות קודמות. זו טענה של החברה ולא בדיקה בלתי תלויה.

Herald of AI מתאר את Qwen4-Max כמודל במשקלים פתוחים, שמפתחים יכולים לחקור, להתאים ולבנות עליו. יש תנאי מסחרי: מי שמרוויח יותר מ-50 מיליון דולר בשנה ממודל בגודל כזה צריך לחתום על הסכם חלוקת הכנסות. במקביל שוחררה גרסה קטנה מזוקקת, Qwen3.8 27B, ברישיון Apache. לא פורסמו במקור תוצאות מבחנים בלתי תלויות. עוד נכתב שבאמצע אוגוסט Qwen4-Max היה המודל הסיני הפתוח השני בגודלו ובעוצמתו, אחרי Kimi K3.

עבור VoiceX, הנתונים הרלוונטיים הם חלון ההקשר והמחיר. מודל שקורא מסמך שלם בבת אחת יכול לעזור בניתוח חומרי מקור ארוכים ובכתיבת תסריטים, במחיר שכדאי להשוות לספקים הנוכחיים. לפני מעבר צריך לבדוק את איכות העברית, את זמני התגובה ואת תנאי הרישיון, כי המקורות לא מתייחסים לעברית בכלל.

למה זה חשוב: הערכה: אפשרות זולה לניתוח מסמכים ארוכים ולכתיבת תסריטים, שכדאי להשוות לספקים הנוכחיים.

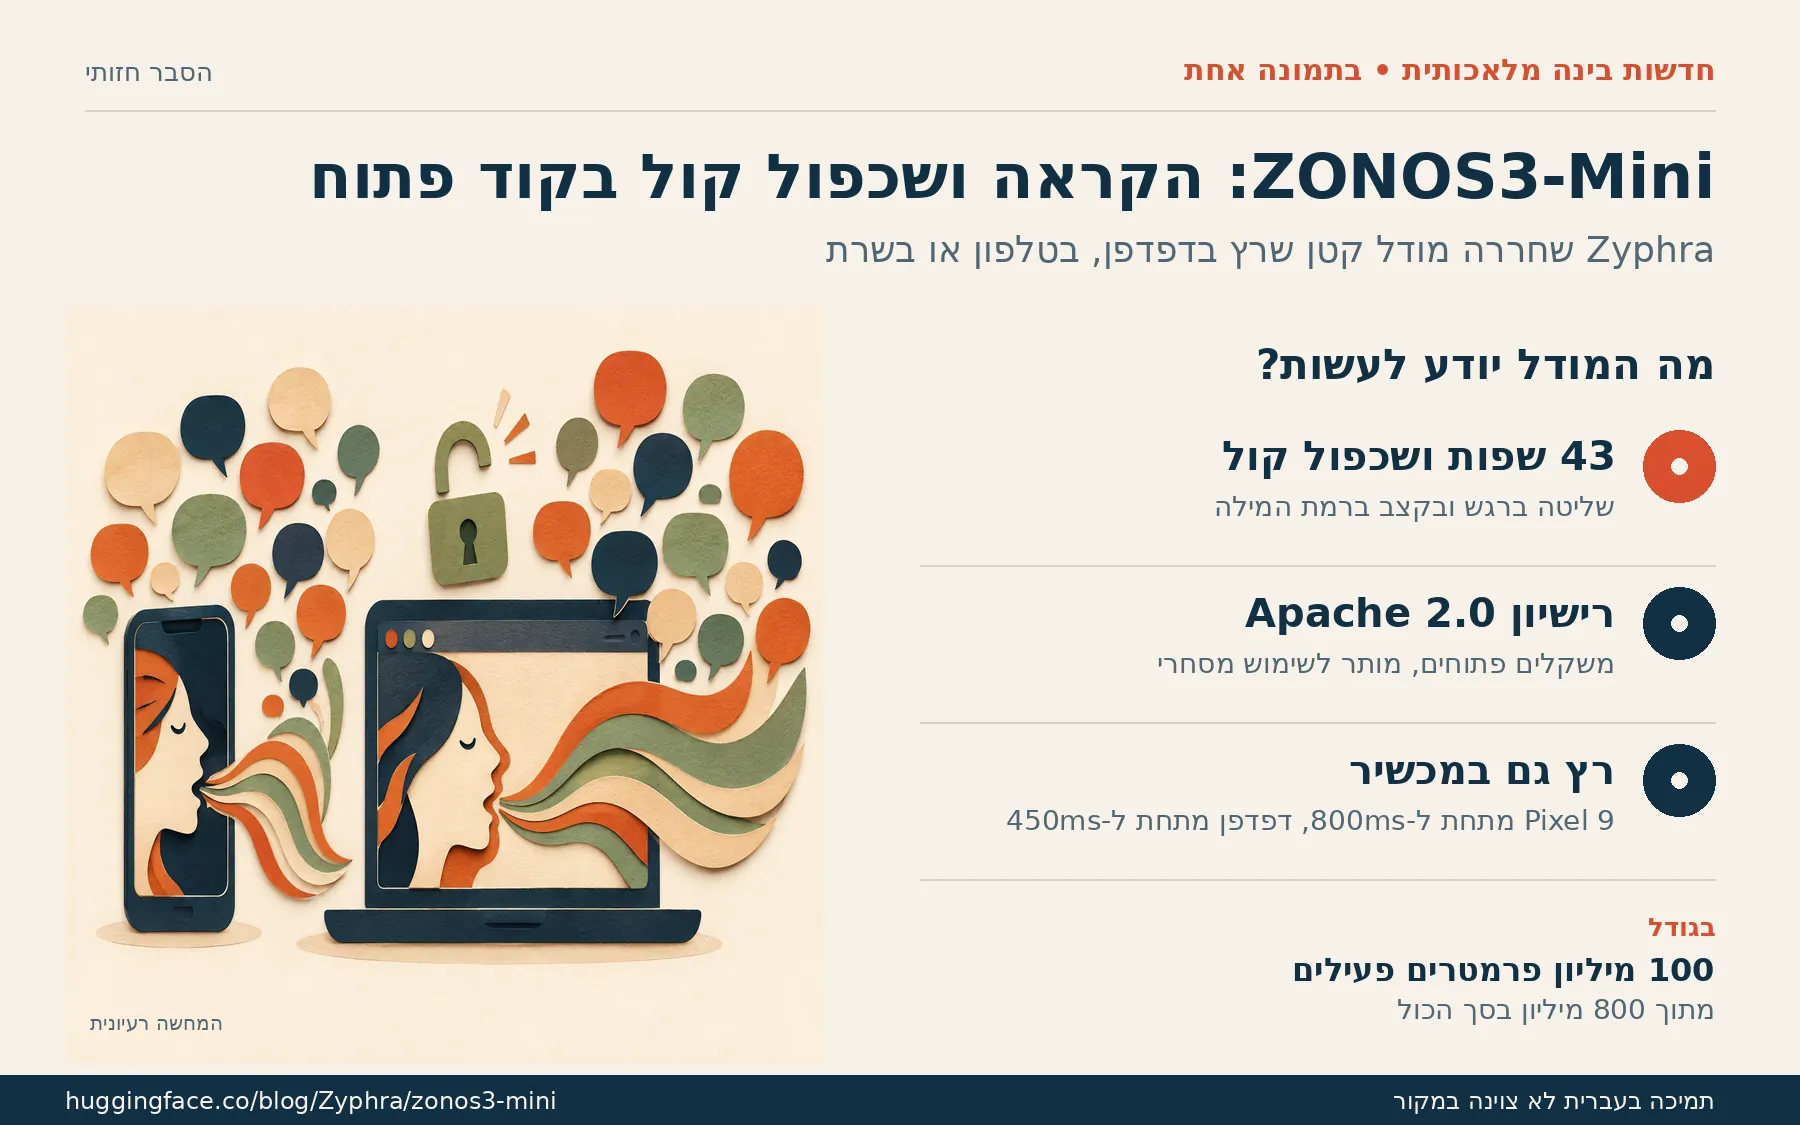
כרטיס הסבר על ZONOS3-Mini של Zyphra: איור נייר של טלפון ומחשב נייד שמהם יוצאים גלי קול ובועות דיבור, ולצדו שלוש נקודות: 43 שפות ושכפול קול, רישיון Apache 2.0, והרצה במכשיר.

רלוונטי ל־VoiceX

ZONOS3-Mini: מודל הקראה ושכפול קול בקוד פתוח שרץ גם בדפדפן ובטלפון

חברת Zyphra שחררה מודל הקראה חדש בקוד פתוח בשם ZONOS3-Mini, שיכול לשכפל קול ולרוץ ישירות על טלפון או בדפדפן. Zyphra היא חברת AI מסן פרנסיסקו שמפתחת מודלים פתוחים. המודל ממיר טקסט לדיבור, תחום שנקרא TTS. הוא יכול לשכפל קול מתוך דגימת אודיו קצרה, או ליצור קול חדש לפי גיל, מבטא ואופי הקול. אפשר גם לשלוט ברגש, בקצב ובאופן ההגשה, עד לרמה של מילה בודדת. לפי החברה, המודל תומך ב-43 שפות. מבחינה טכנית, למודל יש 800 מיליון פרמטרים, אבל בכל שלב פועלים רק 100 מיליון מהם. החברה פיתחה גם רכיב חדש לדחיסת אודיו, שמוריד את מספר היחידות שצריך כדי לייצג שנייה של דיבור מ-774 ל-150. זה מה שמאפשר לו לרוץ מהר על מכשירים פשוטים יחסית. Zyphra מדווחת שזמן התגובה עד האודיו הראשון בטלפון Pixel 9 הוא פחות מ-800 אלפיות שנייה, ובמחשב MacBook Air בדפדפן פחות מ-450 אלפיות שנייה. האימון נמשך יומיים וחצי על 112 כרטיסי NVIDIA H100. המשקלים של המודל זמינים ב-Hugging Face ברישיון Apache 2.0, שמאפשר שימוש מסחרי. הקוד להרצה זמין ב-GitHub, עם גרסאות לדפדפן, לשרתים, למחשבי Apple ולמעבד רגיל. יש גם כלי עריכה בשם Zonos Voice Studio. מי שלא רוצה להריץ בעצמו יכול להשתמש בגרסה המתארחת בשירות הענן של החברה. לפי מבחן שהחברה עצמה פיתחה, ZONOS3-Mini מדורג ראשון בין המודלים הפתוחים שנבדקו. זה מבחן של החברה ולא בדיקה בלתי תלויה. מה זה אומר לבעל עסק קטן או ליוצר תוכן? עד היום, הקראה איכותית דרשה לרוב שירות בתשלום לפי כמות טקסט. מודל פתוח שרץ על מחשב רגיל יכול להוריד את העלות להקראה של קורסים, פודקאסטים וסרטוני הסבר. החברה עצמה מציינת שימושים כמו כלי קריינות, משחקים ועוזרים קוליים. לפני שמשתמשים בו, כדאי לבדוק אם השפה שלכם נתמכת ואיך נשמעת התוצאה.

למה זה חשוב: הערכה: חלופה פוטנציאלית להקראה בתשלום לפי תווים. צריך לבדוק אם עברית נתמכת ומה האיכות בפועל לפני כל החלטה.

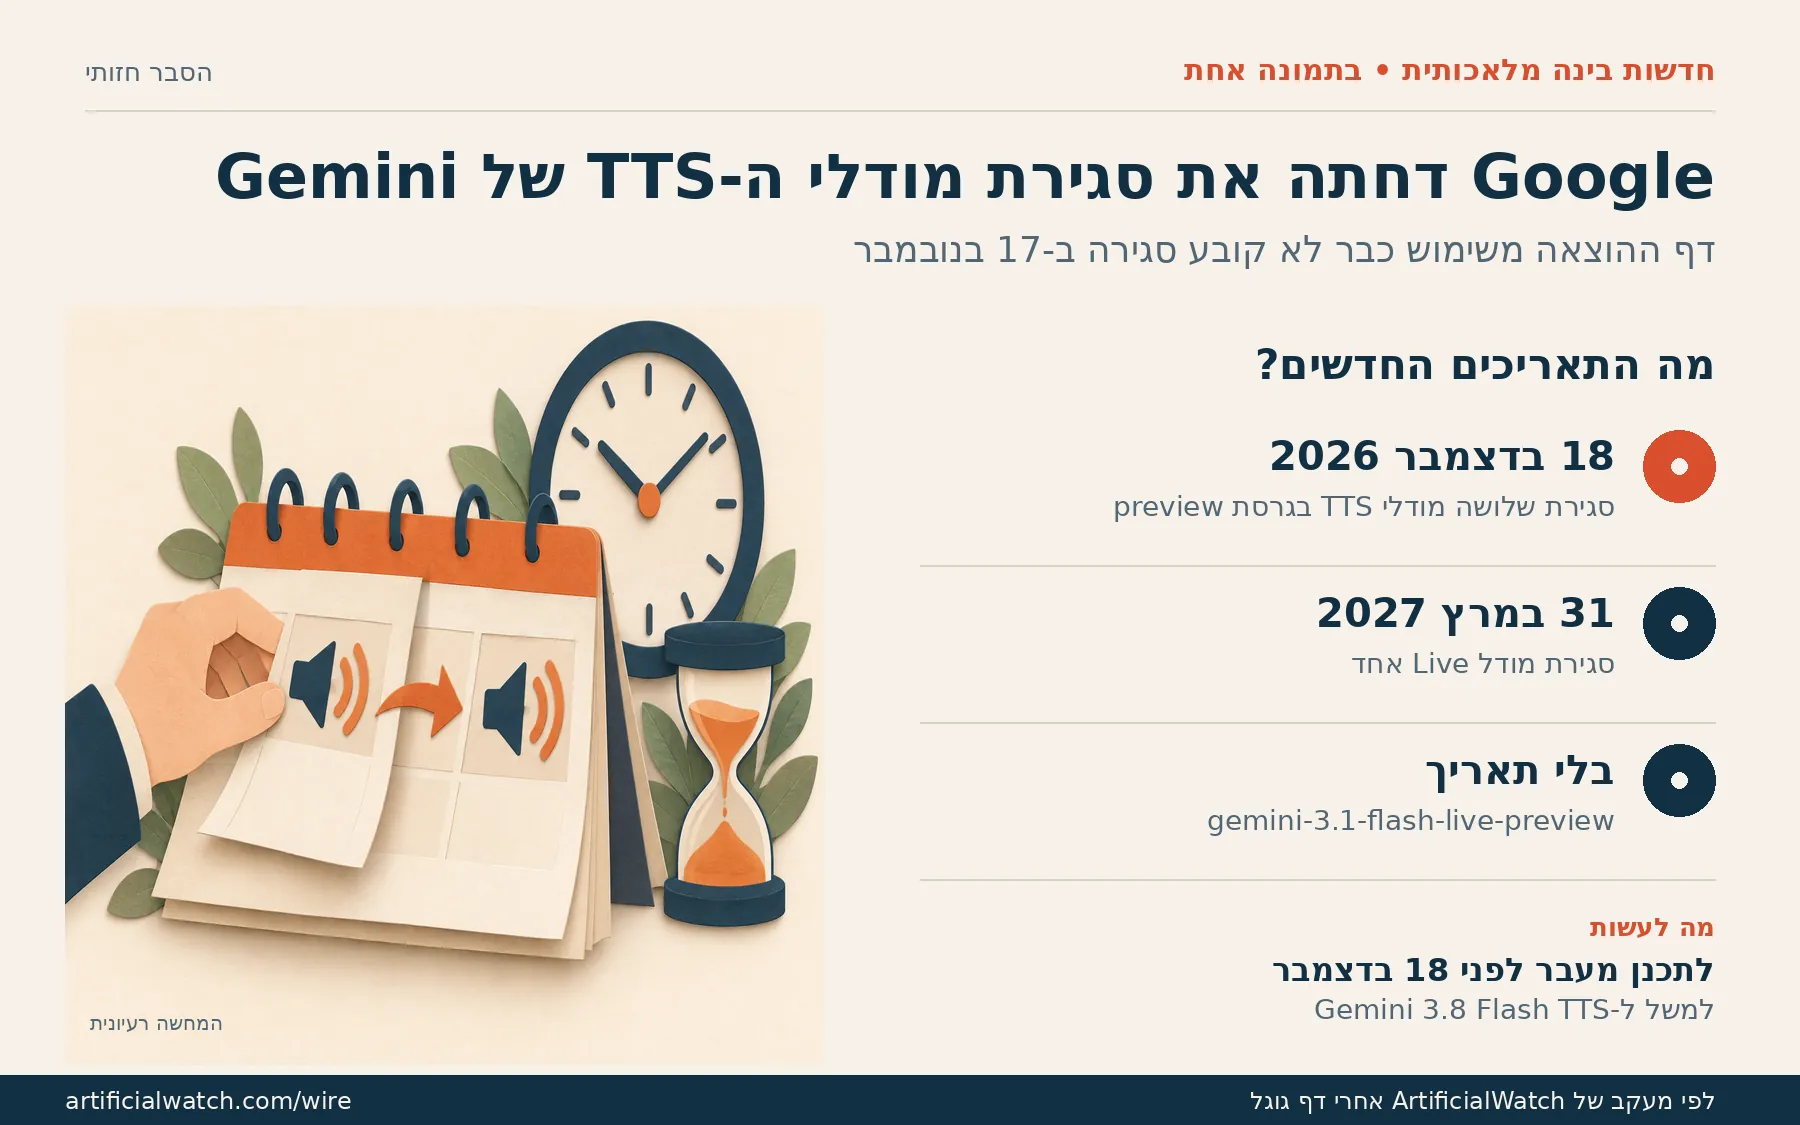
כרטיס הסבר על דחיית סגירת מודלי ה-TTS של Gemini: איור של לוח שנה שדפו מוזז קדימה ליד שעון ושעון חול, ולצדו התאריכים 18 בדצמבר 2026 ו-31 במרץ 2027.

רלוונטי ל־VoiceX

Google דחתה את סגירת מודלי ה-TTS בגרסת preview של Gemini

Google דחתה את מועד הסגירה של כמה מודלי קול בגרסת ניסיון ב-Gemini API, שהיו אמורים להיסגר ב-17 בנובמבר 2026. Gemini API הוא השירות שדרכו מפתחים מחברים את המודלים של גוגל לאפליקציות שלהם. חלק מהמודלים בשירות מסומנים preview, כלומר גרסת ניסיון. לגרסאות כאלה גוגל קובעת מראש תאריך שבו הן מפסיקות לפעול. לפי האתר ArtificialWatch, שבדק את דף ההוצאה משימוש של גוגל ב-14 בנובמבר, הדף כבר לא קובע סגירה של חמישה מודלי קול ב-17 בנובמבר. במקום זה, שלושה מודלים להמרת טקסט לדיבור, TTS, ייסגרו ב-18 בדצמבר 2026. מודל Live אחד, ששימש לשיחות קוליות בזמן אמת, ייסגר ב-31 במרץ 2027. למודל gemini-3.1-flash-live-preview אין כרגע תאריך סגירה בכלל. במקביל, גוגל ממקמת את Gemini 3.8 Live כמודל ברירת המחדל לסוכנים קוליים. לפי יומן השינויים של Gemini API, מודלי ההקראה Gemini 3.8 Flash TTS ו-Gemini 3.8 Flash-Lite TTS שוחררו לזמינות כללית ב-22 בספטמבר 2026. בדף התמחור של Google Cloud הם עדיין מסומנים preview, עם מחיר מוזל עד 31 בדצמבר 2026. ב-Flash TTS המחיר הוא חצי דולר למיליון טוקנים של טקסט ו-9 דולר למיליון טוקנים של אודיו. מ-1 בינואר 2027 המחיר מוכפל, לדולר אחד ול-18 דולר. ב-Flash-Lite TTS מחיר האודיו עולה מ-6 ל-12 דולר. לשם השוואה, באותו דף מופיע Gemini 3.1 Flash TTS, מודל preview שהושק באפריל 2026, במחיר של דולר אחד לטקסט ו-20 דולר לאודיו. Gemini 2.5 Flash TTS עולה חצי דולר לטקסט ו-10 דולר לאודיו, כולם למיליון טוקנים. מה זה אומר לבעל עסק או ליוצר תוכן? מי שבנה מוצר על מודל בגרסת ניסיון צריך לעקוב אחרי תאריכי הסגירה. אם המודל נסגר, ההקראה במוצר פשוט מפסיקה לעבוד. הדחייה נותנת עוד כחודש להתארגן, אבל לא מבטלת את הצורך לעבור. כדאי לחשב מראש גם את העלות אחרי עליית המחיר בינואר.

למה זה חשוב: אם VoiceX משתמשת במודלי TTS בגרסת preview של Gemini, יש עכשיו עד 18 בדצמבר לעבור, למשל ל-Gemini 3.8 Flash TTS.

כרטיס הסבר על הפסקה אפשרית של Veo 3.1: איור של מצלמה ופס סרט שדוהה ליד שלט ריק ולוח שנה, ומצלמה חלופית בצד, ולצדו ההסרה מ-Gemini API, הזמינות ב-Google Cloud והמחירים.

רלוונטי ל־VoiceX

Veo 3.1 ו-Veo 3.1 Fast עלולים להפסיק לפעול החל מ-17.11

לפי סקירת מודלי הווידאו של Slash Digital, דף המודל של Veo 3.1 ב-Google Cloud מציין תאריך הפסקה אפשרי: 17 בנובמבר 2026, כלומר היום. הסקירה מדגישה שזה תאריך אפשרי בלבד, ולא נמצאה הודעה של גוגל שהמודל אכן הפסיק לפעול. זה לא האירוע הראשון בתחום. ב-22 באוקטובר גוגל כבר סגרה את גרסאות ה-preview של Veo 3.1 ב-Gemini API, והחליפה אותן ב-Gemini Omni Flash 1.1. גוגל ממליצה היום על Gemini Omni Flash כמודל הווידאו ברירת המחדל שלה.

נכון לזמן כתיבת הסקירה, Veo 3.1 ו-Veo 3.1 Fast נשארו זמינים באופן כללי ב-Google Cloud וגם דרך Flow, וגרסת Veo 3.1 Lite נמצאת ב-preview. כל הגרסאות יוצרות קטעים של 4, 6 או 8 שניות. Veo 3.1 ו-Fast מגיעים עד 4K, ו-Lite עד 1080p. לכולן יש אודיו מובנה, ויצירה בלי קול זולה יותר. הסקירה מציינת גם שהארכה של קטע יורדת ל-720p, שהפלט הוא ביחס 16:9 או 9:16, ושגוגל מטמיעה סימן SynthID בכל קטע.

המחירים לפי הסקירה, בבדיקה מספטמבר: Veo 3.1 עולה 0.40 דולר לשנייה ו-0.60 דולר ב-4K. Veo 3.1 Fast עולה בין 0.10 ל-0.30 דולר לשנייה, ו-Lite בין 0.05 ל-0.08 דולר. בדוגמת חישוב ב-1080p, 1,600 שניות וידאו יעלו 128 דולר ב-Lite, 192 דולר ב-Fast, 320 דולר ב-Veo 3.1 בלי קול ו-640 דולר עם קול. הכותבים מזהירים שהמחירים משתנים לעיתים קרובות.

עוד פרט שימושי מהסקירה: ב-Gemini API גוגל שמרה סרטוני Veo רק יומיים, ולכן הומלץ להוריד ולשמור כל קטע מאושר ביום היצירה, יחד עם הפרומפט ותמונות המקור. בדירוג של Artificial Analysis לווידאו עם אודיו, Veo 3.1 דורג במקום ה-22 בתחילת נובמבר.

אם VoiceX משתמשת היום ב-Veo 3.1 דרך Google Cloud, כדאי לבדוק עוד היום בדף המודל ובקונסולה אם הוא עדיין עונה, ולוודא שיש מסלול מעבר מוכן, למשל ל-Gemini Omni Flash. כל הנתונים כאן מגיעים ממקור משני ולא אומתו מול גוגל.

למה זה חשוב: אם VoiceX משתמשת ב-Veo 3.1, כדאי לוודא כבר היום שיש חלופה, למשל Gemini Omni Flash. התאריך מבוסס על מקור משני ולא אומת מול גוגל.

כרטיס הסבר על LongCat-Video-Avatar 1.6 של Meituan: איור של אווטאר מדבר על מסך מחשב עם גל קול ופס סרט ארוך ומנעול פתוח, ולצדו סנכרון שפתיים, סרטונים של יותר מ-10 דקות ומצבי קלט.

רלוונטי ל־VoiceX

LongCat-Video-Avatar 1.6: מודל אווטאר מדבר בקוד פתוח (MIT)

Meituan, ענקית המשלוחים הסינית שמפתחת גם מודלי בינה מלאכותית תחת השם LongCat, שחררה ב-15 בנובמבר את LongCat-Video-Avatar 1.6. זו מסגרת בקוד פתוח ליצירת וידאו של אדם מדבר על בסיס קובץ אודיו, והיא ממשיכה את גרסה 1.5. לפי מאגר הקוד של החברה ב-GitHub, משקלי המודל משוחררים ברישיון MIT, כלומר מותר להשתמש בהם גם מסחרית. הרישיון לא נותן זכויות בסימני המסחר או בפטנטים של Meituan.

לפי המפתחים, הגרסה החדשה מביאה תנועות שפתיים טבעיות יותר בזמן דיבור, הבעות פנים ותנועות ראש וגוף עשירות יותר, ופחות הצטברות של שגיאות בסרטונים ארוכים. הם מציינים שיפור באיכות ובעקביות גם בסרטונים של יותר מעשר דקות. כדי להגיע לזה, תהליך האימון האחרון שילב למידת חיזוק, זיקוק לכמה צעדים בודדים ותרגול על סרטונים ארוכים. נוספו גם אופטימיזציות שנועדו לקצר את זמן היצירה.

המודל תומך בכמה מצבים: אודיו וטקסט לווידאו, אודיו ותמונה לווידאו, והמשך של סרטון קיים כדי להאריך אותו. אפשר להשתמש בקובץ אודיו אחד או בכמה קבצים, למשל לשיחה בין שני דוברים. מבחינה טכנית, נקודת הבדיקה של 1.6 בנויה על אותה ארכיטקטורה כמו 1.5, עם שתי שכבות LoRA נוספות, ויש גם גרסת INT8 אופציונלית שחוסכת זיכרון.

עם זאת, יש כמה דברים שהמאגר לא מפרט. אין דרישת חומרה מינימלית רשמית, אבל כל דוגמאות ההרצה מתועדות על שני מעבדים גרפיים. למעבדי Hopper כמו H100 ו-H200 מומלץ להפעיל FlashAttention 3 להאצה. גם הרזולוציה של 1.6 לא מצוינת במפורש; לגרסה 1.5 נכתב שהיא תואמת ל-480p ול-720p. ההתקנה דורשת Python 3.10, PyTorch עם CUDA וכמה ספריות נוספות.

עבור VoiceX, זו חלופה פוטנציאלית לשירותי אווטאר בתשלום לפי דקה, בתנאי שמריצים אותה על שרת GPU משלך. לפני כל החלטה צריך לבדוק איכות בפועל עם קריינות בעברית, זמן יצירה לדקת וידאו ועלות השרת. הטענות על איכות ועקביות הן של המפתחים עצמם, ולא נמצאה עדיין בדיקה בלתי תלויה.

למה זה חשוב: הערכה: חלופה פוטנציאלית זולה לאווטארים בתשלום, אם מריצים אותו על שרת משלך. דורש בדיקת איכות ועלות GPU.

כרטיס הסבר על Leadde: איור של דף אינטרנט, מצגת ומסמך שעוברים על מסוע והופכים למסך וידאו עם מציגה ומיקרופון, ולצדו קישור לווידאו, מסמך לפודקאסט ותרגום ל-88 שפות.

רקע

Leadde מחברת סרטוני הסבר, URL לווידאו ומסמך לפודקאסט עם תרגום ל-88 שפות

Leadde, חברה מסינגפור שמפתחת סביבת עבודה ליצירת וידאו בבינה מלאכותית, פרסמה ב-16 בנובמבר הודעה לעיתונות על הרחבת הכלים שלה. ההודעה מתארת חיבור של כמה תהליכים במקום אחד: יצירת סרטון הסבר מכתובת אתר, הפיכת מסמך או מצגת לפודקאסט, ותרגום של וידאו, תמונות ומצגות. הכול פועל בדפדפן, תחת חשבון אחד ויתרת קרדיטים אחת.

בכלי שהופך קישור לווידאו, המשתמש מדביק כתובת של דף, למשל הערות גרסה או דף נחיתה. המערכת מחלצת ממנו נקודות מרכזיות ובונה מתאר סצנות שאפשר לערוך לפני שנכנסים לעורך. כלי נפרד מקבל קבצי PDF, PPTX, DOC, DOCX ו-TXT ומאפשר לבחור אורך: סיכום של דקה עד שלוש, גרסה מאוזנת של שלוש עד חמש, או העמקה של חמש עד שבע דקות. כלי המצגות מייבא עד 50 שקפים ו-200 מגה-בייט, שומר על השכבות של PowerPoint ומשתמש בהערות הדובר כקריינות.

בתחום הפודקאסט, אפשר להפוך שקפים או מסמך כתוב לתסריט של פרק. העורכים יכולים לבחור קולות מהספרייה, לשכפל קול של דובר מתוך 10 עד 60 שניות הקלטה, להגדיר כללי הגייה לשמות מותגים ולהוסיף הפסקות של 0.1 עד 99 שניות. יש גם 300 אווטארים, אפשרות להפוך תמונת דיוקן למציג, ותשעה סגנונות כתוביות.

בתרגום, החברה מציינת 88 שפות ו-175 דיאלקטים לווידאו ולתמונות. אפשר להחליף טקסט בתוך צילום מסך או תרשים תוך שמירה על העימוד, לתרגם מצגת בלי לשבור את המבנה, ולשמור כל גרסה מתורגמת כפרויקט נפרד שאפשר לתקן לפני הייצוא. דיבוב של קבצי MP4 או MOV קיימים נתמך ביותר מ-15 שפות, עם סנכרון שפתיים אופציונלי.

לפי ההודעה, המסלול החינמי כולל 200 קרדיטים בחודש וסרטונים של עד 10 דקות ב-1080p. מסלול Starter עולה 25 דולר לחודש, ו-Creator עולה 69 דולר וכולל ייצוא 4K.

חשוב לזכור שמדובר בהודעה לעיתונות של החברה עצמה. לא נמצאה בדיקה בלתי תלויה, וההודעה לא מציינת אם עברית נמצאת בין השפות. עבור VoiceX זו בעיקר נקודת השוואה למוצר מתחרה שעושה מסמך לסרטון ולפודקאסט.

למה זה חשוב: הערכה: מתחרה ישיר לרעיון של VoiceX (מסמך לסרטון או לפודקאסט). שווה להכיר את התמחור והתהליך שלה.

התדריך המלא